一张 Tesla T10 16GB 插在十年前的 B85 主板上,Linux 能在 PCI 列表中看见它,驱动却未必能启动。我们这台机器最初遇到的正是这种情况:日志先报 BAR 1 ... failed to assign,随后 nouveau 初始化返回 -12。问题不在于系统内存少了 16 GiB,而是固件给 PCI 设备划出的地址窗口装不下这张卡的 BAR。
本文记录 ASUS B85M-G、i5-4590S 与 Tesla T10 16GB 的一次实机试验:保留 Intel 核显负责桌面,让 T10 负责 CUDA 计算。最终有效的内核参数是 pci=nocrs,realloc=on。下面把原因、试验步骤和验收标准讲清楚,方便在其他旧平台上按自己的资源表尝试。
一、先看结果:这台机器做到了什么
| 项目 | 实机记录 |
|---|---|
| 平台 | ASUS B85M-G(BIOS 3602)、Intel Core i5-4590S |
| 显卡与系统 | Tesla T10 16GB(PCI ID 10de:1e37);Ubuntu 24.04.5 LTS,内核 7.0.0-31-generic |
| 显示与计算 | Intel 核显继续由 i915 驱动;T10 由 NVIDIA 580.173.02 server-open 驱动 |
| PCI 资源 | BAR1 保留完整 16 GiB;BAR3 为 32 MiB;验证时 PCIe 链路为 Gen3 ×16 |
| 功能验收 | nvidia-smi 显示 16384 MiB;普通用户完成 1,048,576 个整数的 CUDA 向量加法,错误数为 0 |
上述结果来自 2026 年 9 月 19 日的这台机器。它证明此配置能在该平台上工作,并不保证所有 B85 主板或其他老平台都具备同样的高地址转发能力。
二、卡住的不是显存,而是地址窗口
PCI 设备的 BAR(Base Address Register)可以理解成设备在 CPU 物理地址空间里申请的一扇“门”。这张 T10 的 BAR1 需要一段连续、对齐的 16 GiB MMIO 地址。这里的 16 GiB 是地址范围,不是从系统 RAM 扣走 16 GiB,也不表示显存预先复制进了内存。
原始启动时,BIOS 通过 ACPI _CRS 声明的主要 PCI 根窗口在 4 GiB 以下,范围约为 0xDF200000–0xFEAFFFFF,只有 505 MiB,而且还要容纳核显、网卡等设备。单是 T10 的 BAR1 就远大于它。即使找到某段看似空闲的地址,也必须满足 BAR 对齐,并让上游 PCIe 桥的转发窗口完整覆盖它。因此,给显卡手工写一个地址并不能单独打通整条路径。
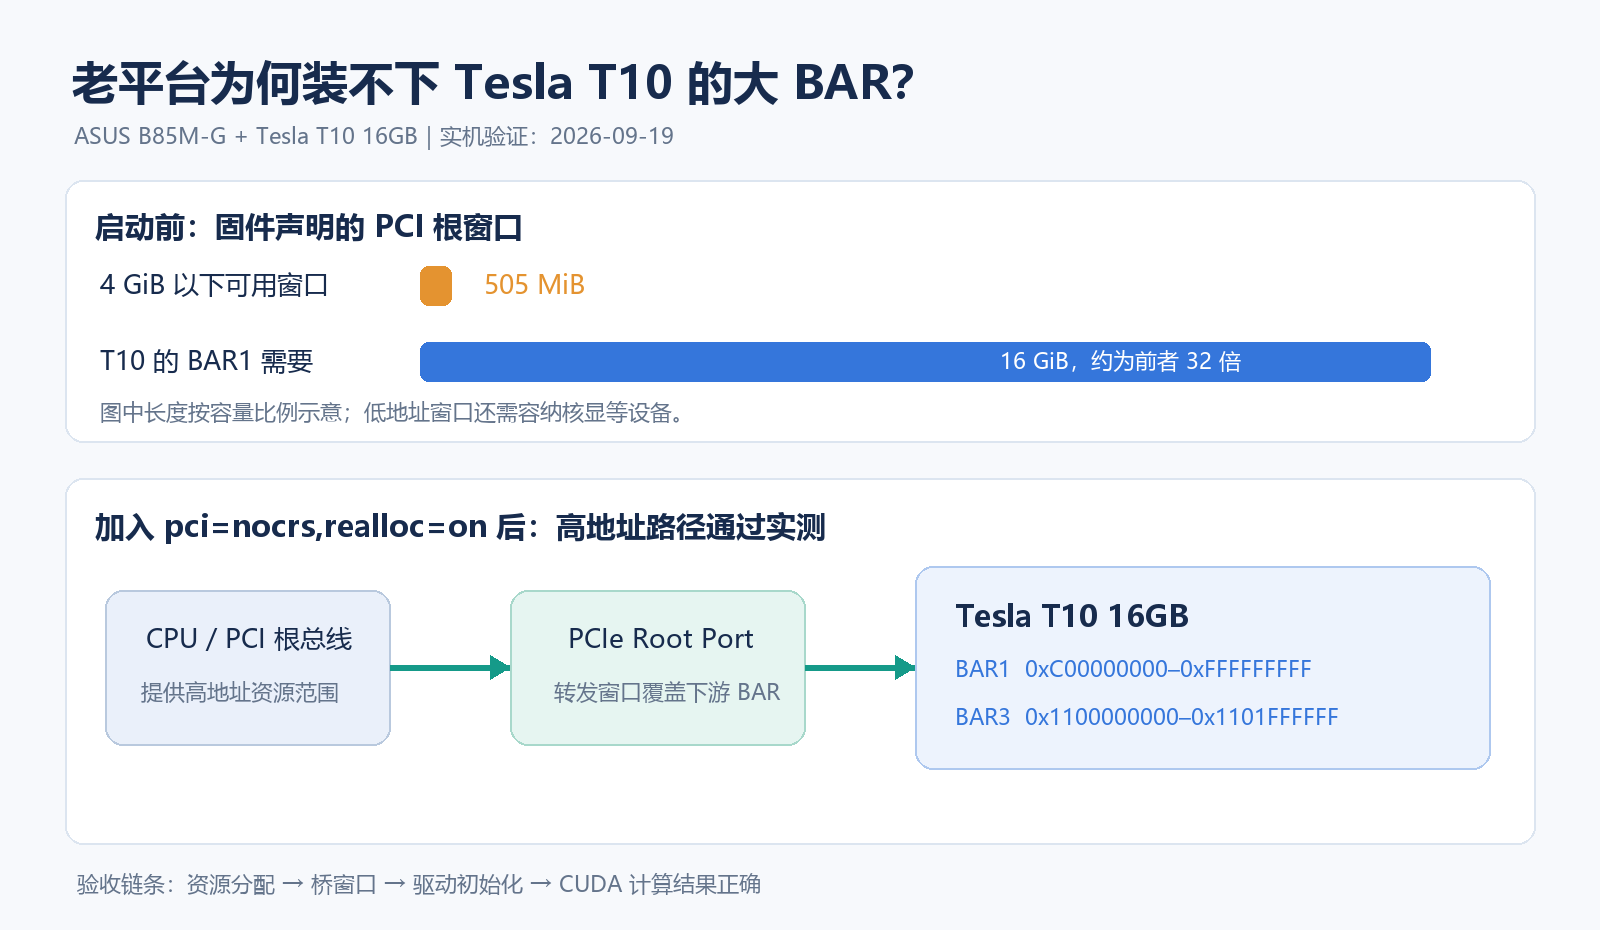
这里最关键的区分是:固件没有声明高地址 PCI 窗口,不等于硬件一定不能访问高地址。前者可从 ACPI 和启动日志看出;后者必须通过可恢复的试验和实际读写验证。
三、两个参数分别解决什么
| 参数 | 作用 | 应当如何理解 |
|---|---|---|
pci=nocrs |
忽略 ACPI 给出的 PCI 主桥窗口描述 | 让内核不再被这台机器的窄固件窗口限定;它不会凭空增加硬件能力,也不是关闭整个 ACPI |
pci=realloc=on |
允许重新分配过小的 PCI 桥资源 | 使桥窗口能够容纳下游设备;单独使用它不一定能突破根窗口的限制 |
两项合写为 pci=nocrs,realloc=on。Linux 官方参数文档分别定义了这两个选项;本机启动日志则给出具体效果:根总线可用资源范围扩展,内核把 BAR1 分配到 0xC00000000–0xFFFFFFFFF,把 BAR3 分配到 0x1100000000–0x1101FFFFFF,并配置上游 Root Port 的预取窗口覆盖这些地址。这些是本机分配结果,不能作为别的机器的固定地址照抄。
四、在旧平台上怎样试
第 1 步:记录原状。先确认 GPU 的 PCI 地址、上游桥地址、当前 BAR、驱动和错误日志。本例 GPU 是 01:00.0、上游桥是 00:01.0;你的机器可能不同。
uname -r
lspci -nn
sudo lspci -vv -s 01:00.0
sudo lspci -vv -s 00:01.0
sudo dmesg | grep -Ei 'BAR|bridge window|failed to assign|nouveau|NVRM'
如果日志已经指向 BAR 分配失败,再试下面的启动参数。最好能接触本地控制台,或具备其他恢复入口;内核启动参数可能影响同一主机上的其他 PCI 设备。
第 2 步:只做一次启动试验。在 GRUB 菜单中选中原 Ubuntu 项,按 e,在以 linux 开头的参数行末尾追加:
pci=nocrs,realloc=on modprobe.blacklist=nouveau panic=30保留原有的 root= 等参数,按屏幕提示以 Ctrl+X 或 F10 启动。这种临时编辑不会改写默认启动项。本例当时尚未安装 NVIDIA 驱动,所以暂时阻止 nouveau 自动加载,先看资源分配,再手动加载验证;已有其他 GPU 驱动的机器要先检查模块配置。panic=30 只能在内核 panic 时尝试延时重启,无法解决硬锁死。
第 3 步:检查整条访问路径。启动后先看参数是否生效,再看 BAR 是否取得非零、大小正确且不冲突的地址,桥窗口是否覆盖下游 BAR。仅有资源表还不够,继续检查驱动初始化。
cat /proc/cmdline
sudo lspci -vv -s 01:00.0
sudo lspci -vv -s 00:01.0
cat /sys/bus/pci/devices/0000:01:00.0/resource
sudo modprobe nouveau
sudo dmesg | grep -Ei 'nouveau|VRAM|init failed'
本机在这一阶段看到 nouveau 识别 16384 MiB 显存,原来的 -12 错误消失。若 BAR 仍为零、桥窗口没有覆盖,或加载驱动后出现访问错误,就先保存日志并回到原启动项,不要直接固化参数。无显示输出的 T10 提示 Cannot find any crtc or sizes,也不能单独当成计算功能失败。
第 4 步:确认有效后再持久化。先备份现有 GRUB 配置,并确认目标片段没有已存在的自定义内容。本机把参数放进 /etc/default/grub.d/99-t10-pci-mmio.cfg,更新 GRUB 后检查生成的正常启动项,只保留 pci=nocrs,realloc=on;临时用的 blacklist 与 panic=30 没有写入默认项。
sudo install -d /etc/default/grub.d
sudo tee /etc/default/grub.d/99-t10-pci-mmio.cfg >/dev/null <<'EOF'
GRUB_CMDLINE_LINUX_DEFAULT="${GRUB_CMDLINE_LINUX_DEFAULT} pci=nocrs,realloc=on"
EOF
sudo update-grub
sudo grub-script-check /boot/grub/grub.cfg
安装 NVIDIA 驱动时,应选与发行版、当前内核和这张卡匹配的软件包。本机使用 Ubuntu 软件源的 580-server-open 计算驱动及对应的预编译模块。可以先查询包是否存在,并用 apt-get -s 预演依赖:
KREL=$(uname -r)
apt-cache policy "linux-modules-nvidia-580-server-open-$KREL" \
  nvidia-headless-no-dkms-580-server-open nvidia-utils-580-server
sudo apt-get -s --no-install-recommends install \
  "linux-modules-nvidia-580-server-open-$KREL" \
  nvidia-headless-no-dkms-580-server-open nvidia-utils-580-server
确认版本和预演结果后再安装这些包。本机还安装了 linux-modules-nvidia-580-server-open-generic-hwe-24.04,用于跟随 HWE 内核更新。其他内核系列应选择对应的模块包,不要把本机版本或包名跨发行版照搬。随后以正常默认启动项重启,用 nvidia-smi、lspci -k 和实际 CUDA 程序验收,检查核显仍由 i915 驱动。
五、怎样判断“真的驱动起来了”
| 检查层级 | 本机的通过证据 |
|---|---|
| 资源分配 | BAR1 获得完整 16 GiB 高地址,BAR3 获得 32 MiB;桥窗口覆盖下游资源 |
| 驱动识别 | nvidia-smi 识别 Tesla T10、驱动 580.173.02 与 16384 MiB 显存 |
| 实际计算 | 普通用户通过 CUDA Driver API 完成 1,048,576 个元素的向量加法,结果全部正确,并完成主机与设备间双向传输 |
| 重启与共存 | 正常默认项重启后仍有效;Intel 核显保持 i915;测试后未见相关 NVRM Xid 或 GPU 掉线错误 |
这比只看见 PCI 设备,或只看见非零 BAR 更有说服力。nvidia-smi 显示的 CUDA Version: 13.0 是驱动支持能力字段,不表示系统已安装完整 CUDA Toolkit;本机测试只用驱动库,没有安装 nvcc。脚本的一次 0.1245 秒运行包含 PTX 加载或 JIT、数据传输、计算与同步回传,不能当作 GPU 算力跑分。本次也没有做长时间满载稳定性测试。
六、适用边界与撤销
nocrs 改变的是内核如何采用固件的 PCI 主桥资源描述,realloc=on 改变的是桥资源分配。它们不是 GPU 仿真层,也不能让原本不支持高地址访问的硬件突然具备该能力。其他老平台是否可用,要以自己的 BAR、桥窗口、驱动初始化和实际计算结果判断。
若只是 GRUB 菜单中的临时编辑,下一次选原启动项即可撤销。若已持久化,把新增的配置片段移出 /etc/default/grub.d,重新运行 update-grub、检查生成配置并重启;若其他文件也写了相同参数,需要一并检查。撤销后 T10 可能重新出现 BAR 分配失败,这是原窗口限制再次生效。
这次试验没有刷新 VBIOS、没有禁用核显,也没有靠缩小 BAR1 或直接改写 VF BAR 换取启动。对于类似故障,值得先问的是“限制来自固件描述,还是硬件通路本身”;可恢复的一次性启动测试,加上实际 CUDA 计算,才能把两者分开。
参考资料
- Linux 内核命令行参数文档:
pci=nocrs与pci=realloc。 - Linux x86 PCI ACPI 资源处理源码。
- NVIDIA System Management Interface 文档:CUDA 版本字段解释。